

Durante 1.000 años, las Murallas Teodosianas de Constantinopla aguantaron todo tipo de ataques. Sin embargo, en 1453 un ingeniero llamado Orbán acabó creando un monstruoso cañón que las derribó. El sultán otomano Mehmed II usó aquella maravilla bélica para conquistar Constantinopla, y para muchos historiadores aquello marcó el final de la Edad Media y el comienzo de una nueva era militar.
En el mundo de los PCs y portátiles Intel y AMD habían construido una muralla similar, aparentemente infranqueable, sobre la arquitectura x86-64 y los sistemas operativos Windows. Ningún otro fabricante ha podido plantear una alternativa en las últimas décadas. Apple enseñó el camino con su chip M1 con arquitectura ARM en 2020, y desde entonces ha logrado convencer a propios y extraños.
Que es justo lo que promete Nvidia con los RTX Spark en Windows.
Y puede que lo consiga. Y con ello, estos chips podrían derribar esa muralla que parecía infranqueable.
Bienvenidos al RTX Spark Day
Lo vimos durante el RTX Spark Day que se celebró en San Francisco el pasado 8 de octubre. Dicho evento reunió a decenas de periodistas de todo el mundo para asistir a la presentación definitiva de un chip y un ecosistema que llega justo a tiempo para sacarle jugo a la revolución de la IA.
Estos chips compiten con los de Intel o AMD en eficiencia y en cargas de trabajo tradicionales (ofimática, creación de contenidos), pero además son propuestas fantásticas para el mundo del gaming y, lo que es más interesante, para dar el salto al mundo de la IA: es posible ejecutar en ellos modelos locales de IA con un rendimiento más que decente.
No es la primera vez que Nvidia intenta algo así. Probó suerte hace más de una década, cuando Microsoft presentó aquellas Surface RT con chips Tegra 3 de la compañía. El producto era llamativo, pero Windows RT demostró no poder competir con su hermano mayor, Windows, y dos años después aquel proyecto decía adiós.
Años después Qualcomm cogió el testigo y quiso apostar por la eficiencia. Las propuestas que han llegado en estos años eran interesantes, pero no lograban conquistar a los usuarios, entre otras cosas porque los videojuegos eran la gran asignatura pendiente. La firma ha seguido trabajando en este ámbito y ha girado su foco a la IA con los Snapdragon X2 Plus, pero de nuevo dejando de lado el mundo gamer.
En esta ocasión la apuesta es distinta y mucho más ambiciosa. Estamos ante una plataforma, la RTX Spark, que ya debutó con los chips N1 y que ahora va más allá con los N1X que gobiernan máquinas más capaces y versátiles. Nvidia no se ha andado con chiquitas, y tuvimos todo ese día de charlas y demos para comprobarlo.
¿Un nuevo principio para el PC?
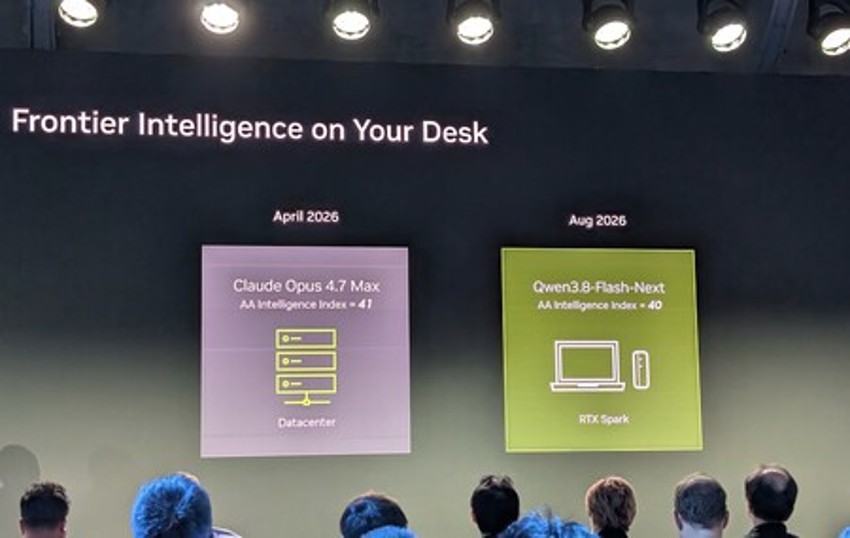
En Nvidia creen que lo es, desde luego. Durante una de las presentaciones, uno de los directivos de la compañía mostró una curiosa gráfica en la que quedaba claro que este chip iba a ser una gran noticia para todos los que buscaban ejecutar modelos de IA locales a un precio aceptable.
Los chips RTX Spark N1X son sin duda muy capaces. Hablamos de ellos en verano, cuando se presentaron en junio de este año, y ya entonces prometían: estos SoC combinan una CPU Grace de hasta 20 núcleos (desarrollada con MediaTek, curioso), y una GPU RTX Blackwell de 6.144 núcleos.
El resultado: un chip capaz de ofrecer un PFLOP en operaciones FP4, una verdadera maravilla para un procesador orientado a portátiles e incluso sobremesas compactos. La GPU ya se estimaba entonces que rendía al nivel de una RTX 5070 para portátiles, y desde luego en las presentaciones vimos corriendo juegos como ‘Cyberpunk’ o el nuevo ‘CONTROL Resonant’ con una fluidez destacable.
Pero es en el ámbito de la IA donde estos equipos se vuelven especialmente interesantes, sobre todo porque pueden ir acompañados de hasta 128 GB de «memoria unificada» —el mismo concepto que usa Apple—. El ancho de banda de dicha memoria LPDDR5X llega hasta los 300 GB/s, una cifra bastante decente y comparable a la de los chips Apple M5 Pro, que llegan a los 307 GB/s.
La ventaja aquí sobre los equipos de Apple está en que la GPU Blackwell hace uso de cuantización FP4, que comprime los datos de forma notable, permitiendo así sacar más partido de esos 300 GB/s. Eso hará posible que estos equipos manejen modelos de IA locales de tamaño considerable con buenos rendimientos, algo que podremos comprobar al probar estos equipos.
Y eso, claro, da margen para algo muy, muy importante: tener una máquina que trabaja por nosotros con IA las 24 horas del día «gratis». Ese «gratis» va con muchas comillas, porque la inversión inicial es muy fuerte: estos equipos no son baratos, pero si uno acaba sacándoles partido, pueden ser de lo más interesantes por esa filosofía de los tokens gratis de la que Nadella y Huang hablaban hace unos días.
Durante una de las presentaciones se dio un ejemplo claro de por qué esto puede ser importante. Hace seis meses, en abril de 2026, podíamos usar Claude Opus 4.7 Max en la nube. Ese modelo tenía un índice de inteligencia en Artificial Analysis de 41 puntos.
Pues bien: en octubre de 2026, seis meses después, es posible usar el modelo Qwen3.8-Flash-Next en un portátil con un SoC RTX Spark y 128 GB de memoria unificada, y atención: ese modelo obtiene 40 puntos en esa misma prueba. Nada, pero nada mal.
La posibilidad de tener modelos de IA de esta calidad corriendo 24/7 es más que llamativa para sacar el máximo partido de agentes de IA como OpenClaw o Hermes, que desde luego ya se podían usar anteriormente pero que ahora cobran una nueva dimensión con este nuevo nivel de «inteligencia local». Así lo destacó Dillon Rolnick, CEO de Nous Research, que participó brevemente en el evento para hablar de cómo Hermes podía trabajar por nosotros en todo tipo de escenarios y hacer una pequeña y llamativa demo.